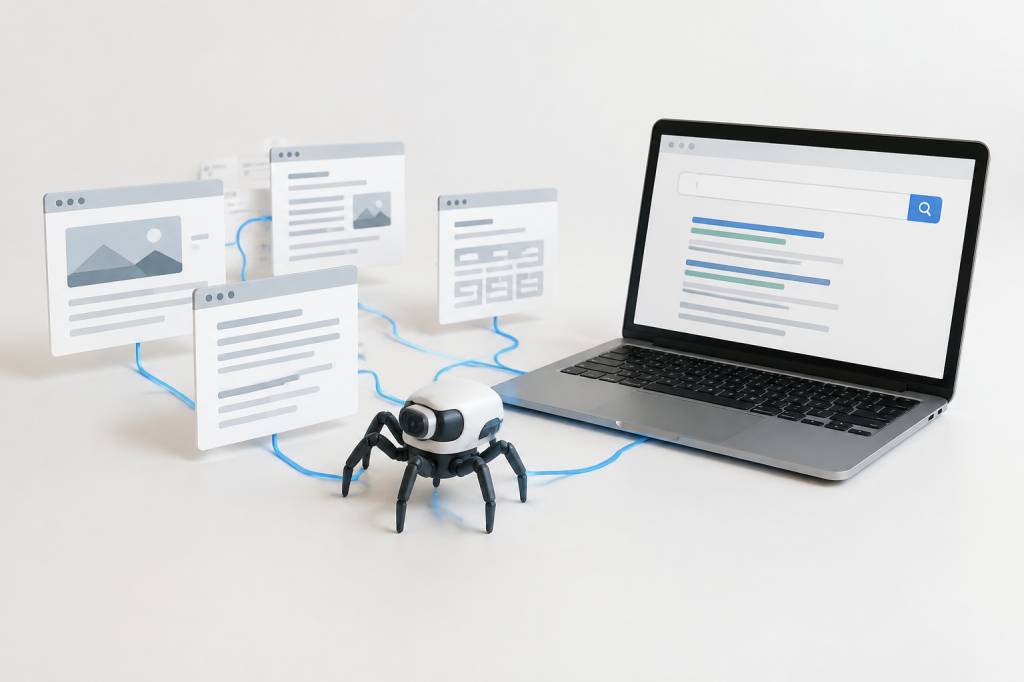
Avant qu’une page apparaisse dans Google, plusieurs étapes sont nécessaires. Les moteurs de recherche doivent d’abord la découvrir, accéder à son contenu, puis décider s’il est pertinent de l’ajouter à leur index. Cette première étape porte un nom : le crawling SEO, aussi appelé exploration ou crawl.
On imagine parfois les moteurs de recherche comme des bibliothécaires capables de tout lire instantanément. En réalité, ils parcourent des milliards de pages en permanence, avec des ressources limitées et des priorités précises. Votre site doit donc être facilement accessible et clairement organisé pour être exploré dans de bonnes conditions.
Mais comment fonctionne concrètement le crawling ? Quels fichiers et réglages peuvent faciliter ou bloquer l’exploration de vos pages ? Et surtout, comment vérifier que Google passe bien sur votre site ? Voici les points essentiels à connaître.
Le crawling SEO, c’est quoi exactement ?
Le crawling désigne l’exploration des pages web par des robots, également appelés crawlers, spiders ou robots d’exploration. Google utilise principalement Googlebot, tandis que Bing s’appuie sur Bingbot.
Ces robots se déplacent de page en page en suivant les liens qu’ils trouvent. Lorsqu’ils arrivent sur une URL, ils tentent d’en récupérer le contenu : texte, images, liens, fichiers JavaScript, feuilles de style et autres ressources nécessaires à l’affichage de la page.
Le fonctionnement peut être résumé en trois grandes étapes :
- La découverte : le moteur identifie une URL grâce à un lien, un sitemap XML ou une autre source.
- L’exploration : le robot visite l’URL et analyse les ressources accessibles.
- Le traitement : le moteur évalue le contenu avant de décider s’il doit être indexé.
Le crawling ne garantit donc pas qu’une page sera visible dans les résultats de recherche. Une page peut être explorée sans être indexée. À l’inverse, une page difficile à explorer risque de ne jamais être correctement comprise par Google.
Crawling, indexation et positionnement : trois notions différentes
Ces termes sont souvent utilisés comme s’ils désignaient la même chose. Pourtant, ils correspondent à des étapes bien distinctes.
- Crawling : Google visite et lit une page.
- Indexation : Google conserve cette page dans sa base de données et peut l’afficher dans ses résultats.
- Positionnement : la page apparaît à une certaine place pour une requête donnée.
Prenons un exemple simple. Vous publiez un article sur les balises title. Google découvre l’URL via votre sitemap, explore la page, puis l’ajoute éventuellement à son index. Ensuite, selon la qualité du contenu, la concurrence, l’intention de recherche et l’autorité de votre site, l’article peut se positionner sur des requêtes comme « optimiser une balise title ».
Si la page n’est jamais crawlée, elle ne peut normalement pas être indexée correctement. Si elle est crawlée mais marquée noindex, elle ne sera pas conservée dans l’index. Et si elle est indexée mais peu pertinente, elle risque de rester très loin dans les résultats. Chaque étape mérite donc une attention particulière.
Comment les robots découvrent-ils vos pages ?
Les moteurs de recherche utilisent plusieurs chemins pour trouver de nouvelles URL. Le premier, et souvent le plus naturel, repose sur les liens internes.
Lorsqu’un robot explore votre page d’accueil et trouve un lien vers une catégorie, puis vers un article, il peut suivre cette structure pour parcourir votre site. Un maillage interne logique facilite ainsi la découverte des contenus et aide Google à comprendre leur importance relative.
Les liens externes jouent également un rôle. Si un autre site fait référence à une page de votre domaine, les moteurs peuvent découvrir cette URL par ce biais. Cela ne signifie pas qu’il faut multiplier les liens artificiels : un lien pertinent, placé sur un site fiable, est bien plus utile qu’une longue liste de liens de faible qualité.
Enfin, le sitemap XML fournit aux moteurs une liste des URL importantes de votre site. Il ne force pas Google à explorer toutes les pages indiquées, mais il lui donne un itinéraire supplémentaire, particulièrement utile pour les sites volumineux, les nouvelles pages ou les contenus peu accessibles depuis le maillage interne.
Le rôle du fichier robots.txt
Le fichier robots.txt se trouve généralement à la racine du site, à l’adresse https://www.exemple.com/robots.txt. Il donne des indications aux robots sur les zones qu’ils peuvent ou ne peuvent pas explorer.
Une directive comme celle-ci demande aux robots de ne pas explorer le dossier « admin » :
User-agent: *Disallow: /admin/Ce fichier peut être très utile pour éviter l’exploration de zones sans intérêt SEO : espaces privés, résultats de recherche internes, paramètres techniques ou environnements de test.
Mais attention à une confusion fréquente : bloquer une URL dans robots.txt ne revient pas à la désindexer. Si une page est bloquée, Google ne peut pas forcément lire son contenu ni voir une éventuelle directive noindex. L’URL peut toutefois apparaître dans les résultats si elle est connue grâce à des liens externes.
Pour demander le retrait d’une page de l’index, il faut généralement utiliser une balise noindex, une directive HTTP équivalente ou une procédure adaptée dans Google Search Console. Le choix dépend du cas rencontré.
Le sitemap XML : un plan utile, mais pas magique
Un sitemap XML recense les URL que vous souhaitez voir prises en compte par les moteurs. Il est particulièrement intéressant dans les situations suivantes :
- Votre site contient beaucoup de pages.
- Vous publiez régulièrement de nouveaux contenus.
- Certaines pages sont peu reliées entre elles.
- Votre site est récent et possède encore peu de liens externes.
- Vous gérez un site e-commerce avec de nombreuses catégories et fiches produits.
Un sitemap propre doit contenir des URL accessibles, canoniques et utiles. Évitez d’y inclure des pages supprimées, redirigées, bloquées ou marquées noindex. Cela enverrait des signaux contradictoires aux moteurs.
Sur WordPress, de nombreux plugins SEO génèrent automatiquement un sitemap. Cela ne dispense pas de le vérifier. Une petite visite dans Google Search Console permet de contrôler sa lecture et de repérer d’éventuelles erreurs.
Le budget de crawl : pourquoi Google ne visite pas tout indéfiniment
Le budget de crawl correspond, de manière simplifiée, à la quantité de ressources qu’un moteur peut consacrer à l’exploration d’un site sur une période donnée.
Pour un petit site vitrine de quelques dizaines de pages, ce sujet reste généralement secondaire. En revanche, il devient important pour les sites e-commerce, les médias, les plateformes et les portails qui génèrent des milliers, voire des millions d’URL.
Google prend notamment en compte deux éléments :
- La capacité de crawl : le rythme auquel le serveur peut répondre sans être surchargé.
- La demande de crawl : l’intérêt de revisiter une page selon sa popularité, sa fraîcheur et sa fréquence de mise à jour.
Une architecture qui produit des milliers d’URL presque identiques peut donc gaspiller une partie des ressources d’exploration. C’est le cas des sites qui créent une URL pour chaque combinaison de filtres : couleur, taille, marque, prix, ordre de tri… Le robot peut se perdre dans un véritable labyrinthe de variantes.
Pour limiter ce problème, vous pouvez réduire les URL inutiles, encadrer les paramètres, améliorer le maillage interne et utiliser les balises canoniques lorsque plusieurs pages présentent un contenu très proche.
Les principaux obstacles au crawling
Une page peut être difficile à explorer pour des raisons techniques, éditoriales ou structurelles. Voici les problèmes les plus fréquents :
- Les erreurs serveur : les codes 5xx indiquent que le serveur rencontre un problème. Des erreurs répétées peuvent inciter les robots à réduire leur fréquence de passage.
- Les redirections en chaîne : une URL qui redirige vers une autre, elle-même redirigée vers une troisième, ralentit l’exploration.
- Les liens cassés : les erreurs 404 interrompent le parcours et dégradent l’expérience utilisateur.
- Les pages orphelines : elles existent, mais aucun lien interne ne permet de les atteindre facilement.
- Les contenus chargés uniquement en JavaScript : Google sait traiter le JavaScript, mais ce traitement peut demander davantage de ressources et de temps.
- Les temps de chargement élevés : un serveur lent peut limiter le nombre de pages explorées.
- Les blocages accidentels : une règle robots.txt trop large ou une balise
noindexoubliée peut rendre une page invisible.
Une anecdote classique en SEO : un site fraîchement mis en ligne reste introuvable pendant plusieurs jours parce que l’environnement de préproduction a conservé une directive bloquant tous les robots. Le contenu est excellent, le design impeccable… mais Google n’a tout simplement pas le droit d’entrer.
L’importance de l’architecture et du maillage interne
Un site bien organisé aide les robots à comprendre la relation entre les pages. Il aide aussi les visiteurs à trouver rapidement l’information qu’ils recherchent. C’est une situation gagnant-gagnant, comme on les aime en SEO.
Dans l’idéal, les pages stratégiques doivent être accessibles en quelques clics depuis la page d’accueil ou depuis une catégorie pertinente. Les liens internes peuvent également transmettre une partie de la popularité et donner des indications sur le sujet de la page cible grâce à leur texte d’ancrage.
Un lien comme « découvrir notre guide du crawling SEO » est plus explicite que « cliquez ici ». Il informe à la fois l’utilisateur et le moteur sur ce qu’il trouvera derrière le lien.
Pour auditer votre structure, posez-vous quelques questions :
- Les pages importantes reçoivent-elles suffisamment de liens internes ?
- Existe-t-il des contenus accessibles uniquement via le moteur de recherche interne du site ?
- Les catégories sont-elles cohérentes et compréhensibles ?
- Les liens conduisent-ils vers des pages actives et pertinentes ?
- La profondeur de navigation est-elle raisonnable ?
Comment vérifier le crawling de votre site ?
Google Search Console est l’outil de référence pour observer la manière dont Google interagit avec votre site. Le rapport d’indexation permet d’identifier les pages explorées, indexées, exclues ou concernées par une erreur.
L’outil d’inspection de l’URL fournit également des informations précieuses. Vous pouvez savoir si une URL est connue de Google, si elle peut être explorée, si elle est indexée et quelle version canonique a été retenue.
Pour obtenir une vision plus technique, les logs serveur sont particulièrement utiles. Ils enregistrent les visites des robots et permettent de répondre à des questions concrètes :
- Googlebot visite-t-il réellement mes pages importantes ?
- Quelles URL sont explorées le plus souvent ?
- Les robots passent-ils du temps sur des pages inutiles ?
- Mon serveur renvoie-t-il des erreurs lors des visites ?
- Les nouvelles pages sont-elles découvertes rapidement ?
Des outils de crawl SEO comme Screaming Frog, Sitebulb ou Oncrawl peuvent compléter cette analyse. Ils simulent l’exploration d’un site et repèrent les liens cassés, les redirections, les pages orphelines, les balises problématiques ou les profondeurs excessives.
Les bonnes pratiques pour faciliter l’exploration
Pour donner toutes les chances à vos pages d’être correctement explorées, concentrez-vous sur des fondamentaux solides :
- Créez une architecture claire, organisée autour de catégories logiques.
- Ajoutez des liens internes pertinents entre vos contenus.
- Générez un sitemap XML propre et maintenez-le à jour.
- Vérifiez régulièrement votre fichier robots.txt.
- Corrigez les erreurs 4xx et 5xx importantes.
- Limitez les redirections et évitez les chaînes inutiles.
- Améliorez les performances et la stabilité du serveur.
- Utilisez les balises canoniques lorsque plusieurs URL se ressemblent.
- Évitez de créer des milliers de pages pauvres ou presque identiques.
- Contrôlez les directives
noindexet les réglages SEO après chaque mise en ligne.
Le plus important est de ne pas chercher à « attirer » les robots à tout prix. L’objectif consiste plutôt à leur proposer un site lisible, cohérent et utile. Un bon crawling est souvent le résultat naturel d’une bonne expérience utilisateur et d’une architecture pensée avec méthode.
Une checklist rapide avant de publier une nouvelle page
Avant de mettre un contenu en ligne, prenez quelques secondes pour vérifier les éléments suivants :
- L’URL est-elle accessible sans connexion particulière ?
- La page est-elle reliée à au moins une autre page du site ?
- La directive
noindexest-elle absente si vous souhaitez être visible ? - Le fichier robots.txt ne bloque-t-il pas l’URL ?
- La page renvoie-t-elle un code HTTP 200 ?
- Le contenu répond-il à une intention de recherche identifiable ?
- L’URL doit-elle apparaître dans le sitemap XML ?
- La page possède-t-elle une version canonique cohérente ?
Cette vérification ne prend que quelques minutes et peut éviter une mauvaise surprise plusieurs semaines plus tard.
Le crawling au service d’une stratégie SEO durable
Le crawling SEO n’est pas un sujet réservé aux développeurs ou aux grands sites e-commerce. Même un blog de petite taille gagne à surveiller l’accessibilité de ses pages. Un article soigneusement rédigé ne pourra pas attirer de visiteurs depuis Google si les robots ne peuvent pas le découvrir ou le comprendre.
La bonne approche consiste à combiner technique, contenu et bon sens : une structure simple, des liens utiles, des pages rapides, des consignes cohérentes et des contenus réellement pensés pour les internautes.
Et si vous commenciez par une action très concrète ? Ouvrez Google Search Console, inspectez vos pages les plus importantes et vérifiez qu’elles sont bien accessibles, explorables et indexées. Vous aurez rapidement une première photographie de la santé SEO de votre site — sans avoir besoin de sortir la loupe du détective.